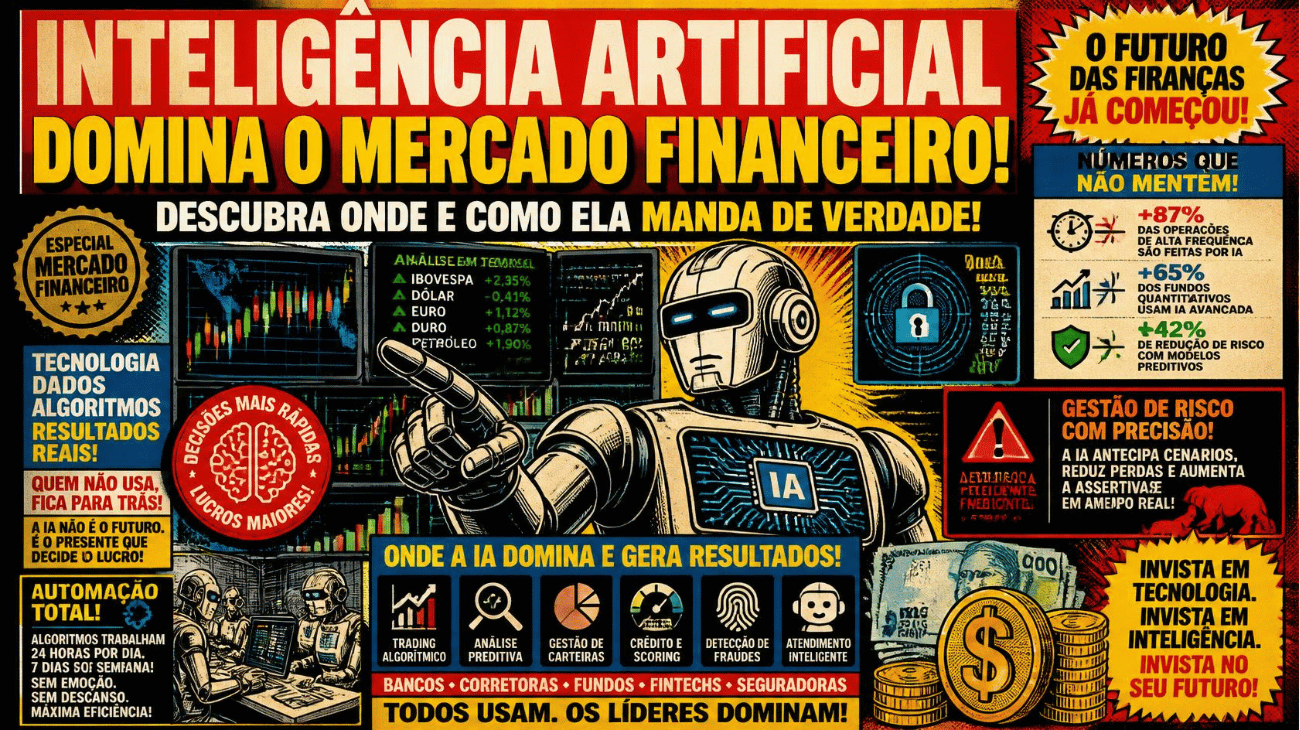
A IA no mercado financeiro deixou de ser promessa. Em algumas áreas específicas, ela já toma decisões sozinha, em tempo real, sem passar por aprovação humana, e é justamente aí que vale a pena olhar com atenção, porque é onde o retorno técnico e o risco de erro são maiores.
Este artigo não é uma introdução genérica sobre “o que é IA”. É um mapa de onde a IA já manda de fato no setor financeiro, como esses sistemas são construídos e o que qualquer desenvolvedor ou empreendedor de tecnologia precisa entender antes de tratar isso como mágica.
O que muda quando a IA entra na decisão financeira
A diferença entre “usar IA” e “IA mandar de verdade” está em quem toma a decisão final. Em muitos sistemas, a IA só sugere e um humano aprova. Nos casos que importam de verdade, o modelo decide sozinho: aprova ou nega um pagamento, bloqueia uma transação, ajusta um preço, tudo em milissegundos, sem intervenção humana no loop.
Isso muda o nível de exigência técnica. Um modelo que sugere é tolerante a erro. Um modelo que decide sozinho precisa de monitoramento constante, testes de viés e um plano claro para quando ele erra, porque ele vai errar.
Detecção de fraude: o campo onde a IA é indispensável
Detecção de fraude é provavelmente a área financeira onde a IA já é insubstituível. O volume de transações é grande demais e os padrões de fraude mudam rápido demais para regras fixas darem conta sozinhas.
Na prática, esses sistemas combinam:
- Modelos supervisionados, treinados em transações já marcadas como fraude ou legítimas;
- Detecção de anomalias não supervisionada, para pegar padrões novos que o modelo nunca viu;
- Scoring em tempo real, geralmente com latência de poucos milissegundos, porque a decisão precisa acontecer antes da transação ser concluída.
O ponto técnico interessante aqui é o trade-off entre falso positivo e falso negativo. Bloquear uma compra legítima irrita o cliente; deixar passar uma fraude gera prejuízo direto. Ajustar esse limiar é decisão de negócio, não só de engenharia, e é um erro comum tratar isso como problema puramente técnico.
Score de crédito: machine learning decidindo quem recebe empréstimo
O score de crédito tradicional usava poucas variáveis e regras estáticas. Os modelos de machine learning usados hoje incorporam centenas de variáveis (comportamento de pagamento, dados transacionais, até padrões de uso de aplicativo) para prever risco de inadimplência com mais granularidade.
Isso traz um ganho real de precisão, mas também um problema conhecido: explicabilidade. Em vários países, negar crédito exige justificativa clara ao cliente. Um modelo de árvore de decisão dá isso com facilidade; uma rede neural profunda, não. Isso empurra times de engenharia para técnicas como SHAP e LIME, só para conseguir explicar uma decisão que o próprio modelo “sabe” tomar, mas não sabe justificar.
Quem só olha para acurácia do modelo e ignora explicabilidade está resolvendo o problema errado.
Trading algorítmico: decisões em milissegundos
No trading algorítmico, a IA não sugere ordem de compra: ela executa. Modelos analisam sinais de mercado, notícias, order book e histórico de preços, e decidem comprar ou vender em frações de segundo, sem qualquer aprovação humana no caminho.
Por que isso não é “robô adivinhando”
O que sustenta esses sistemas não é previsão mágica de preço, é gestão estatística de risco em alta frequência: dezenas de sinais combinados, limites de exposição automáticos e regras de circuit breaker que desligam o sistema se o comportamento sair do esperado. A parte mais crítica, na prática, não é o modelo que decide comprar: é o sistema que decide quando parar de confiar no modelo.
Atendimento com IA: onde funciona e onde ainda falha
Chatbots e assistentes de IA em instituições financeiras funcionam bem para triagem, consultas de saldo, segunda via de boleto e dúvidas repetitivas. Funcionam mal, e ainda geram reclamação, em qualquer situação que exija julgamento contextual, como negociação de dívida ou disputa de cobrança.
O erro comum de quem implementa isso é tratar o assistente como substituto total do atendimento humano, em vez de filtro inteligente que escala o que realmente precisa de uma pessoa.
Compliance e regtech: IA monitorando o que humano não dá conta
Regtech é uma das aplicações mais silenciosas e mais sólidas de IA no setor: modelos monitoram transações continuamente em busca de padrões de lavagem de dinheiro, geram alertas para os times de compliance e reduzem o volume de revisão manual. Aqui a IA raramente decide sozinha: ela prioriza, e humano decide. Ainda assim, é a única forma viável de monitorar volume de transações em escala.
Como isso é construído na prática (visão técnica)
Stack comum nesses sistemas
Não existe “a” stack única, mas um padrão se repete em boa parte das implementações:
- Python como linguagem principal, com Scikit-learn para modelos mais simples e TensorFlow ou PyTorch para redes neurais;
- Pipelines de dados em tempo real, normalmente com Kafka ou Spark Streaming, porque decisão de fraude e trading não tolera processamento em lote;
- Feature stores, para garantir que a mesma variável usada no treino seja calculada de forma idêntica em produção (uma das causas mais comuns de modelo que funciona no notebook e falha em produção);
- Infraestrutura de baixa latência, já que scoring de fraude e trading algorítmico competem por milissegundos.
O ponto que a maioria subestima: MLOps e monitoramento
Colocar um modelo em produção é a parte fácil. O trabalho real é o monitoramento contínuo: detectar drift de dados (quando o padrão do mundo real muda e o modelo passa a errar mais), reavaliar viés periodicamente e ter um plano de rollback claro. Times que tratam IA financeira como projeto de “treinar e publicar”, sem esse acompanhamento, são os que voltam a fazer notícia por motivo errado.
Limitações e riscos que ninguém deveria ignorar
- Viés nos dados: se o histórico usado para treinar carrega viés, o modelo reproduz e às vezes amplifica esse viés.
- Falta de explicabilidade: modelos complexos entregam decisão sem justificativa clara, o que é problema legal em crédito e compliance.
- Dependência excessiva de padrões passados: modelos treinados em dados históricos podem falhar justamente nos eventos atípicos, que são os que mais importam.
- Superfície de ataque nova: sistemas de decisão automática também podem ser alvo de manipulação adversarial, um risco que times de segurança tradicionais nem sempre consideram.
Perguntas Frequentes sobre IA no Mercado Financeiro
A IA substitui completamente analistas financeiros?
Não. Ela substitui tarefas repetitivas de análise de dados e scoring, mas decisões estratégicas e casos fora do padrão continuam exigindo julgamento humano.
Qual a diferença entre IA e automação tradicional em finanças?
Automação tradicional segue regras fixas (“se X, então Y”). IA aprende padrões a partir de dados e ajusta o comportamento com novas informações, sem que alguém reescreva regra por regra.
IA no mercado financeiro é só para bancos grandes?
Não. Fintechs e empresas menores usam as mesmas técnicas, muitas vezes via APIs de terceiros ou modelos open source, sem precisar construir tudo do zero.
Quais são as maiores barreiras técnicas para implementar IA em finanças?
Qualidade e volume de dados históricos, exigência de explicabilidade regulatória e necessidade de infraestrutura de baixa latência para decisões em tempo real.
Conclusão: onde a IA manda de verdade (e onde ainda não)
A IA no mercado financeiro já manda de verdade em áreas bem específicas: detecção de fraude, score de crédito, trading algorítmico e monitoramento de compliance. Nessas frentes, o modelo decide, e o humano supervisiona à distância. Fora delas, em atendimento complexo, decisões estratégicas, situações atípicas, a IA ainda é ferramenta de apoio, não substituto.
Para quem constrói esse tipo de sistema, o desafio real não é treinar um modelo com boa acurácia. É mantê-lo confiável, explicável e monitorado depois que ele já está tomando decisões sozinho, porque é aí que o erro custa caro.